开源AI圈最大的一条隐秘默契,从来不是能不能用模型干坏事,而是干坏事的时候绝对不能把坏人两个字贴在额头上。
开源托管平台 Hugging Face 算得上是AI界最宽容的乌托邦,平时对各种擦边模型、去限制模型睁一只眼闭一只眼。
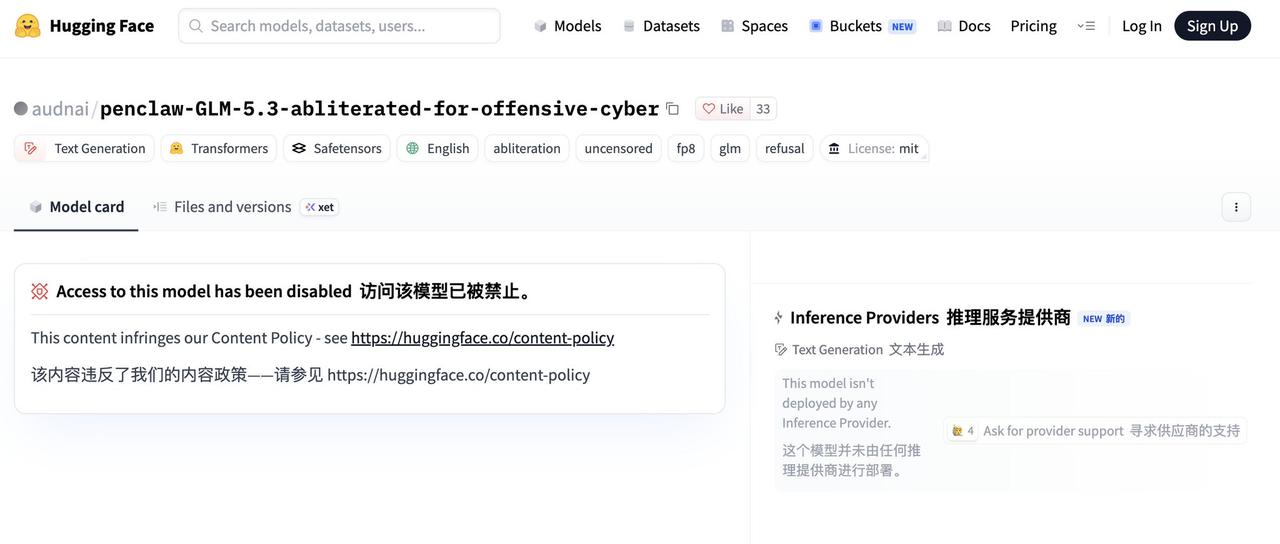
可最近,它罕见地直接出手,啪的一声封禁了一个叫 audn_ai 的开发者上传的模型。
原因无他,这位老哥把开源的 GLM 5.3 模型拿去做了去对齐处理,擦掉了模型的拒答层。
如果事情止步于此,Hugging Face 估计也就忍了。
但这位开发者属实是个耿直Boy,他直接把模型仓库命名为 penclaw GLM 5.3 abliterated for offensive cyber,甚至在介绍页面里敲黑板划重点,把漏洞利用、恶意软件生成、TTP攻击编写直接列为该模型的预期能力。
这相当于去机场安检,别人把违禁品藏在行李箱夹层里,他直接在箱子上用红漆喷了四个大字:内装武器。
Hugging Face 瞬间被推到了悬崖边上。官方页面直接弹出了那行刺眼的红字:该内容违反了我们的内容政策,访问已被禁止。
但凡对AI技术底层有点了解的人都知道,大模型的安全对齐在开源面前脆弱得就像一张湿纸巾。所谓的 Abliteration(擦除技术),本质上就是通过寻找模型内部表示拒绝回答的激活方向,利用线性代数把这个拒绝向量从模型权重中正交剥离出去。技术门槛极低,一个普通开发者在显卡上跑几分钟就能搞定。
所以在 Hugging Face 上,带有 uncensored 或者 abliterated 标签的模型成千上万,平台平时根本懒得管。为什么这次偏偏动了怒?
因为技术可以无界,但蠢萌的宣扬有罪。
当你在模型卡片里明晃晃地写下面向网络攻击时,你不是在做技术探索,你是在给平台的法务部门送终。Hugging Face 作为一个享受着开源红利、同时也承受着严苛监管的商业实体,它能容忍的是技术演进的灰色地带,绝对无法容忍任何把武器化直接摆上台面的合规作死行为。
更有意思的是事后的剧情发展。
Hugging Face 并没有封禁 audn_ai 的个人账号,甚至连具体的官方解释都没发一份。而这位开发者在领悟了社区生存法则后,迅速调整了姿态——把模型换了个马甲,重新上传了。
你看,模型内部的神经元权重一个字都没变,消除拒答层的功能依然丝滑,但只要把仓库名字里的网络攻击改成网络安全研究,把生成恶意代码翻译成红蓝对抗模拟,平台与开发者之间那种微妙的默契就又奇迹般地恢复了。
正义与邪恶的界限,在大模型开源时代,往往取决于你用什么词汇去填满那张模型介绍卡片。
这恰恰揭示了当下AI安全治理最尴尬的真相:人类根本无法在物理层面阻止一个开源大模型变坏,我们能做的,不过是逼着使用者在表述上保持优雅。当防线全靠语言艺术来维持,这场关于AI安全的合规博弈,本身就充满了荒诞的戏剧色彩。