前阵子复现 AgentOPSD 时,我就觉得:让“带着经验的自己”教自己,已经有点 RSI 的感觉了[害羞R]
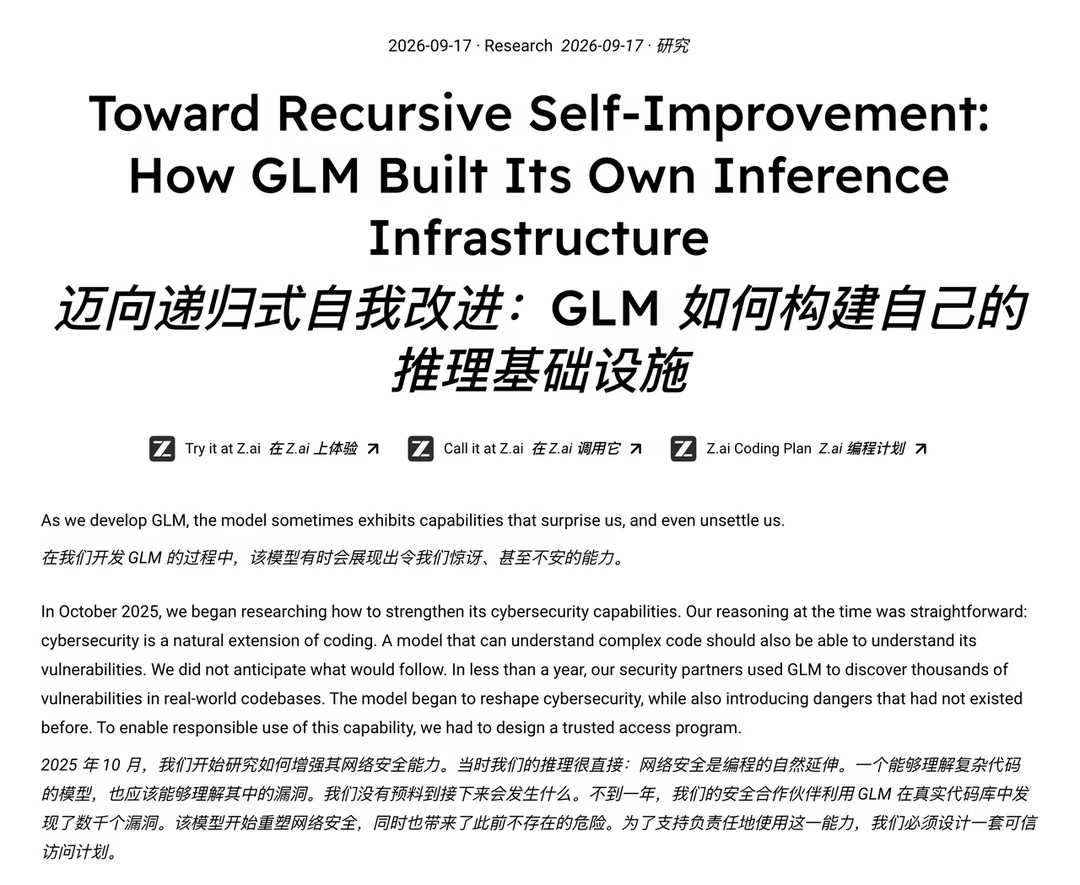
今天看 GLM 团队这篇报告,又想起了这件事,毕竟 GLM 5.3 已经开始给 GLM 修底座了[偷笑R]
RSI,递归自我改进,我理解最关键的地方就是:AI 参与改进 AI 系统,这轮改进又能帮助它完成下一轮改进。经验和能力,要一轮轮进行学习和优化[萌萌哒R]
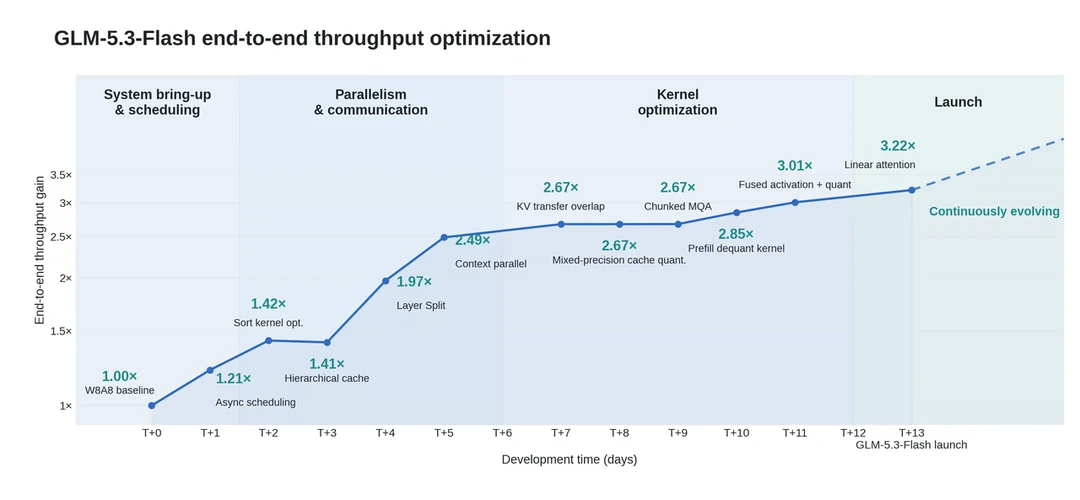
GLM-5.3 驱动的 Infra Agent 参与建设了 GLM-5.3-Flash 的推理系统。工程师和 Agent 一起,在不到两周内完成适配到生产可用,端到端吞吐达到初始基线的 3 倍[萌萌哒R]
其实我最想聊的是中间怎么做到的。给 Agent 一句“吞吐下降了”,它也得猜。智谱把反馈拆到了具体算子、线程和执行时间线,再让它自己提假设、改代码、做对照实验。反馈要局部、及时,还得能客观验证[萌萌哒R]
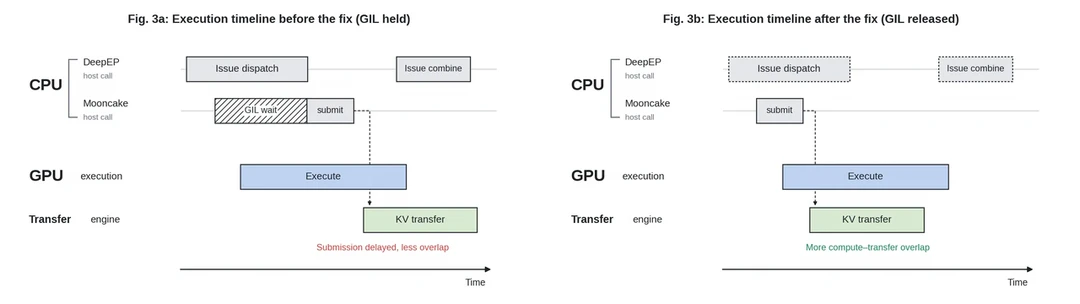
比如有个 KV 缓存传输问题。Agent 沿着时间线查到,DeepEP 的部分 C++ 调用一直占着 Python 的 GIL,负责提交传输任务的线程只能等。底层能异步,上层却卡住了[萌萌哒R]
这种细节的描述,我挺喜欢的,让技术报告看上去不那么冰冷了吧,模型进步还得靠实验说话。更关键的是,验证有效的优化,会连同适用条件存回“优化骨架库”,供后续任务使用。下一轮终于能接着上一轮的经验干活了[萌萌哒R]
这也让我想到 AgentOPSD:同一个模型带着 Skill,给自己已经走过的动作重新算概率,把差异变成逐轮训练信号,再通过训练更新权重。一个在改推理系统,一个在把经验转成训练信号,我觉得都在补 RSI 需要的环节[萌萌哒R]
GLM 这次仍由工程师设目标、审关键修改;我的复现也用了固定 SkillBank。完整自主进化,还需要继续做。但在成熟、可靠的持续学习方法普遍落地之前,RSI 依然是我最看好的 AI 进化方向[萌萌哒R]
前几天看到《我不得不把才华埋葬在昨天》,我能理解告别一门热爱技术的失落,但我还是更期待 AI 带来的那个更加波澜壮阔的明天[doge][doge][doge]
#智谱 #智谱AI #GLM #glm53 #glm53flash #rsi #howto入门codex #我这行的AI路 #howto学ai #大模型