现在来看,黄仁勋之前作出的预测,十有八九是对的。
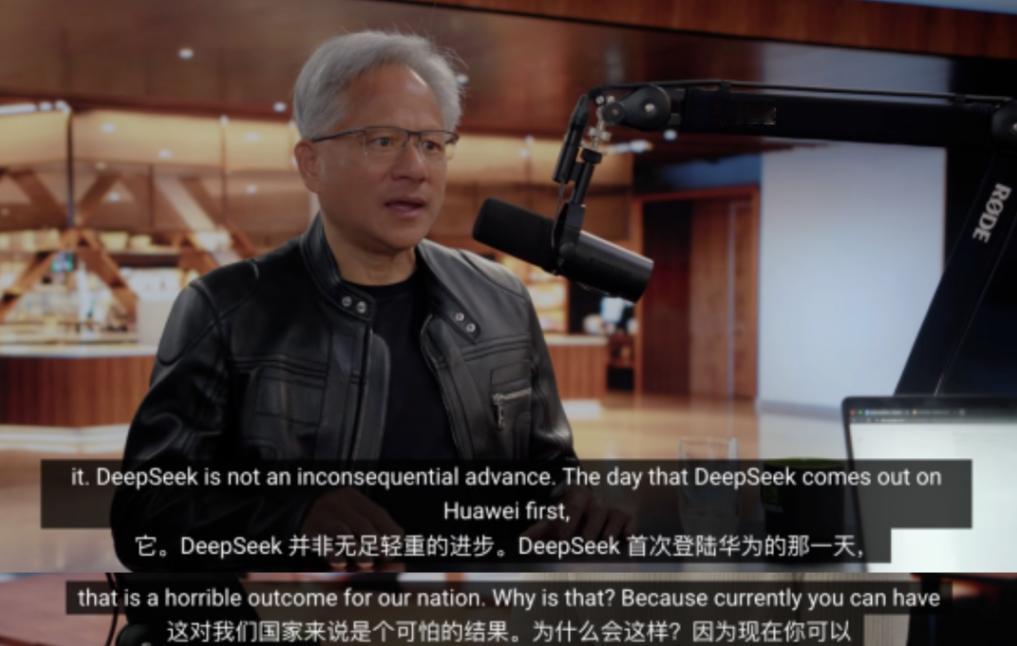
黄仁勋此前说DeepSeek首次跑在华为芯片上,对美国是个可怕的结果。当时都以为他在帮英伟达要政策。现在看,他是认真的。
DeepSeek选华为,不是退而求其次,是强强联手。
把时间拨回今年4月,黄仁勋谈到DeepSeek时,担心的并不只是英伟达少卖几块芯片。他更在意一件事:如果有影响力的开放模型率先围绕华为的软硬件体系做优化,开发者随后也在这套体系里训练、部署和改进模型,美国技术栈原有的优势就会受到挑战。
这里面的门道,比“国产芯片能不能点亮一个大模型”深得多。模型能跑起来,只是第一步;能否跑得快、成本是否划算、长时间运行是否稳定,才决定企业愿不愿意真金白银地用。就像一辆车能上路,不代表它已经适合天天跑长途。
DeepSeek-V4在4月24日发布并开放权重,华为云当天宣布完成适配。华为做的工作也不是简单把模型文件搬到服务器上:从计算算子、任务调度到缓存管理,都针对新模型的结构做了调整。
尤其是百万Token上下文,用户觉得是“能读更多内容”,服务商面对的却是更大的缓存压力,以及更多并发请求。处理不好,回答越长,等待越久,账单也越厚。
这正是双方合作有价值的地方。DeepSeek擅长从模型结构上提高效率,华为掌握芯片、集群、软件工具和云服务。模型设计知道硬件擅长什么,硬件优化也知道模型最需要什么,双方就能少走很多“先开发、再硬搬”的弯路。
强强联手,强在彼此能改进对方,而不是把两个响亮的名字印在同一张海报上。
这种配合还有一个现实背景:大模型的竞争已经从发布会上的性能榜,走到了企业每天调用多少次、每次花多少钱的阶段。DeepSeek在9月推出V4.1 Flash,继续强调效率和服务成本。
用户未必关心机房里是哪款芯片,却会在意高峰期会不会卡、长文档处理是否可靠、价格能否支撑日常使用。谁能把这些问题解决,谁才有机会把技术变成生意。
华为这边也在持续补齐底座。去年3月,已有超过40家企业在昇腾AI云服务上部署DeepSeek;今年9月,华为介绍昇腾950超节点的规模商用进展,并发布新一代超节点。把这些节点连起来看,从模型适配、企业部署到集群扩展,这条路正在往前走。
真正有说服力的进展,往往不是一次演示跑出多漂亮的数字,而是客户下个月还愿不愿意继续用。
黄仁勋为什么会觉得这件事棘手?因为芯片生意从来不只是卖硬件。开发者熟悉什么工具,工程师会优化什么架构,企业已经在哪个平台部署服务,都会影响下一次采购。
一个热门开放模型若带动更多人熟悉昇腾平台,芯片、软件和应用就可能互相推着往前走。英伟达多年来积累的生态优势,也恰恰建立在这种循环之上。
我认为,这比单纯争论“谁的单卡参数更高”更值得关注。
先进芯片当然重要,但真实业务需要的是整套系统协同:芯片供给跟不跟得上,集群连接是否顺畅,软件是否好用,出了故障能否迅速恢复,最后都要落到成本和体验上。
某个环节卡住,再漂亮的模型也难以大规模服务用户。产业竞争没有一招制胜的按钮。
对DeepSeek而言,更多成熟的算力选择意味着更大的部署空间;对华为而言,有前沿模型持续提出难题,芯片和软件才能在实际使用中反复打磨。
这种关系远比“谁依赖谁”的口水仗有意思。模型不是摆在展柜里的奖杯,芯片也不是只看参数表的收藏品,两者最终都得在用户的任务里接受检验。
当然,把眼下的进展直接说成全球AI格局已经改写,还太早。高性能推理、大规模训练和长期稳定商用是不同的考题,不能因为一道题答得漂亮,就提前宣布整场考试结束。
黄仁勋当时提出的是对生态走向的担忧;今天的合作进展,说明这种走向已有现实基础,但最终能走多远,还要看产品、产能和客户选择。
在我看来,最值得高兴的不是让谁“害怕”,而是中国企业正在把模型创新和算力建设接得更紧。过去讨论AI,常常是模型归模型、芯片归芯片;现在双方开始一起解决具体的工程问题。能把好模型稳定、便宜地送到更多人手里,这才是强强联手最实在的成绩。