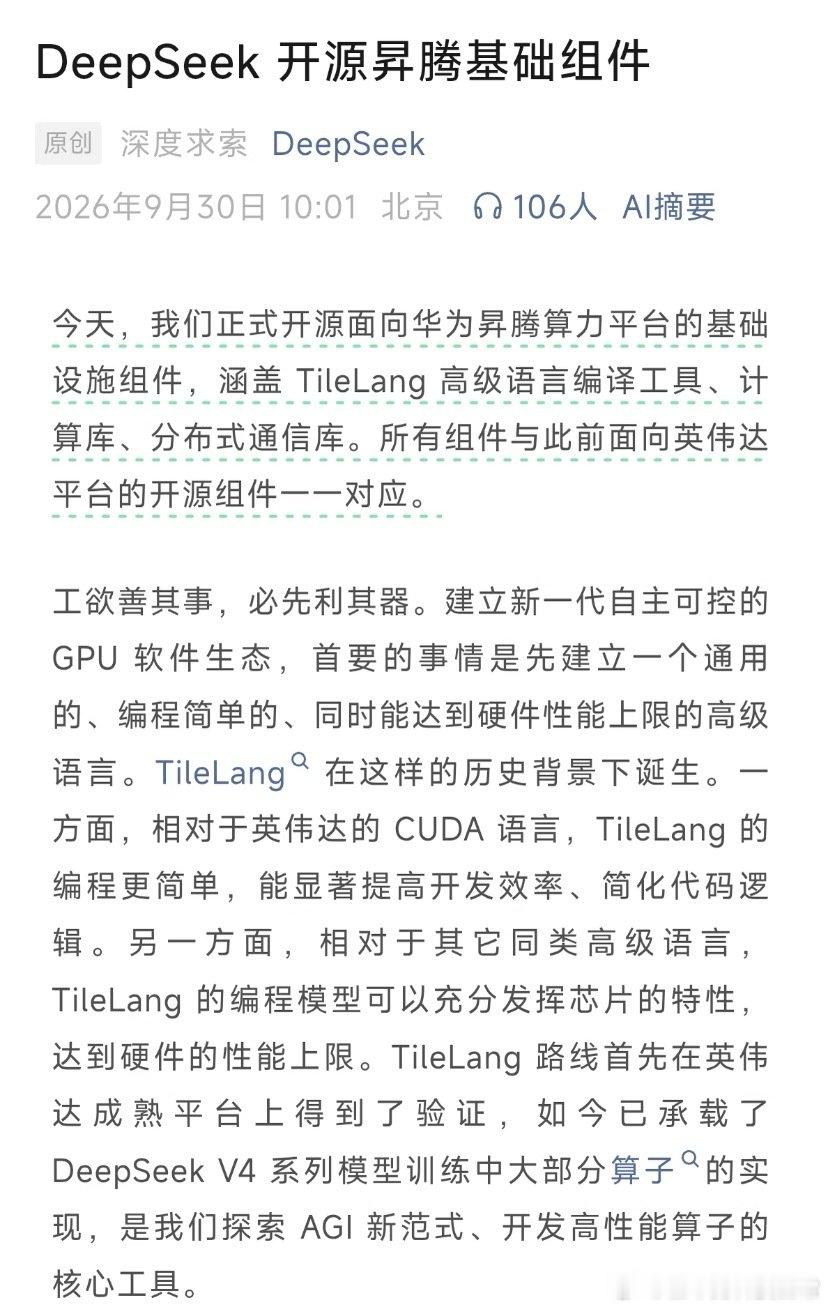
黄仁勋万万想不到,自己筑了二十年的CUDA高墙,最后给中国模型公司做了嫁衣。国庆假期前,DeepSeek 做出硅谷难以理解的抉择:全套适配华为昇腾芯片的开发工具、底层高性能算子,一次性对外开源。
9月30日,国庆假期前一天,DeepSeek把这份"大礼包"摆上了桌。
里面有TileLang编程语言的昇腾版编译工具,有DeepGEMM、FlashMLA、TileKernels、DeepSelect几个计算库,还有专门负责多张卡之间传数据的通信库DeepEP。
DeepSeek说,这些组件和它早先给英伟达平台开源的那一套是一一对应的。
说到这儿,得先唠两句CUDA是个啥,芯片本身就是一块会算数的硅片,想让它干活,得有人把程序员写的代码翻译成芯片能听懂的指令。
英伟达2006年推出的CUDA,就是这样一整套翻译工具,外加一堆现成的零件,掐指一算,今年正好二十年。
这二十年里,全世界做AI的人差不多都是在CUDA上练的手。
模型里最基础的计算步骤,行话叫"算子",比如一次矩阵乘法,大多是照着英伟达的芯片反复调出来的。
换一家芯片,就等于让人把练熟的手艺扔掉重来,老实讲,这堵墙高就高在人的习惯上,芯片参数反倒没那么要命。
"嫁衣"这个说法从哪儿来?2025年2月,DeepSeek办过一次开源周,FlashMLA、DeepEP、DeepGEMM就是那时候发布的,当时这几样全是给英伟达GPU写的,专门把显卡的性能往死里抠。
可以这么讲,DeepSeek压榨硬件的那身功夫,就是在CUDA这个练兵场上磨出来的。
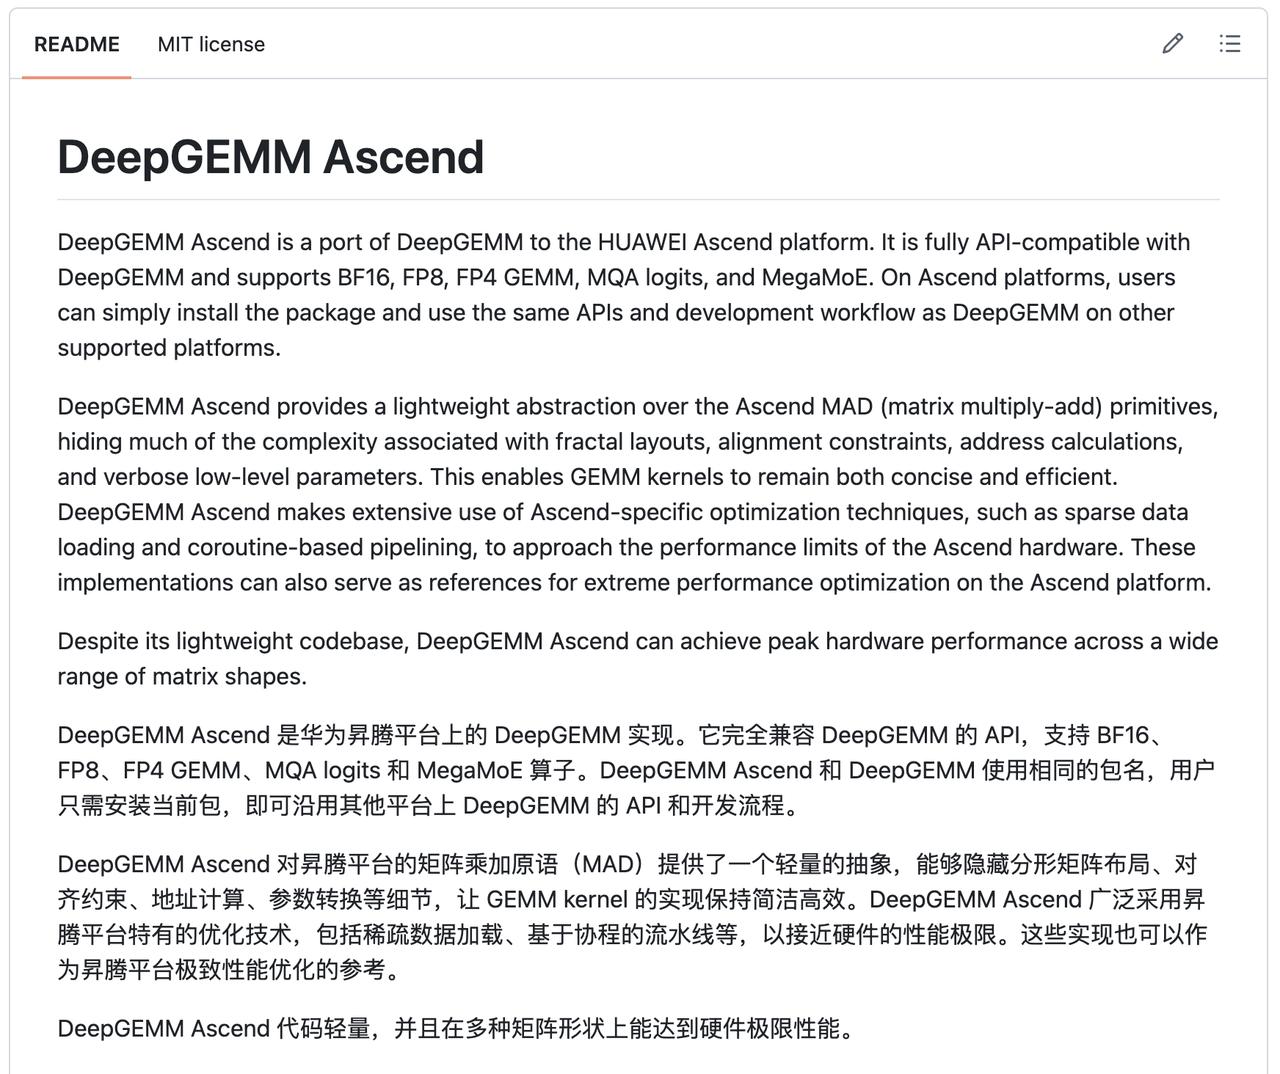
如今这身功夫原样搬到了昇腾上,几个库的名字基本没改,GitHub上就是在后面加了个Ascend,在我看来,"嫁衣"两个字的分量全在这儿。
英伟达二十年搭起来的训练场,带出了一支吃透底层的中国团队,这支团队学成之后,转身就把经验写进了国产芯片的工具箱。
光有态度不够,还得看成绩,据财联社报道,在EP32部署下,DeepSeek-V4.1-Flash做离线推理时,如果每生成一个token(可以粗略理解成一个字)只给5毫秒,每张卡每秒能输出2469个token;放宽到10毫秒,能到5102个,通信库的两项带宽分别跑到了375GB/s和347GB/s。
网易科技还报道了另一组数字:FlashMLA在昇腾950上,预填充阶段达到硬件峰值的95%,解码阶段是83%,说实话,看到95%的时候我愣了一下。
我原本以为第一版能摸到八成就算交差了,没想到离天花板只差一口气。
这份成绩背后,华为出了不少力,DeepSeek在发布中专门提到,研发过程中华为团队给了毫无保留的大力支持。
双方一起推进基于昇腾950的128卡超节点方案,华为配套的SuperPoD Flex组网能做到128卡3.2Tbps单层交换,一边写软件,一边造硬件,配合得挺默契。
回头看,这一步并不是拍脑门定的,2025年9月29日DeepSeek发布V3.2-Exp时,TileLang的昇腾版本就同步开源了。
2026年4月24日V4预览版发布,华为当天宣布昇腾全系列产品支持,从模型适配到工具链开源,这条路是一段一段铺过来的。
黄仁勋对这件事其实心里很清楚,今年4月中旬,他在一档播客访谈里说,如果DeepSeek的模型在华为芯片上完成优化,对美国会是一个可怕的结果。他担心的事情4月走了一步,9月底又走了一大步。
我寻思,他当时大概没料到,DeepSeek会连工具链都一起送出去。
按硅谷的常规打法,底层工具就是护城河,自己攥着都嫌不够紧,DeepSeek倒好,DeepGEMM的昇腾版直接用了MIT许可证,谁都能拿去用、拿去改,商用也不收钱。
要是只看一家公司的利润表,这笔买卖确实有点"亏"。
依我看,DeepSeek算的是另一本账,昇腾上用的人越多,暴露的问题就越多,工具也磨得越快,回过头来受益的还是它自己。
更要紧的是,国内其他模型公司想上国产芯片,不用再从零开始写算子,门槛一下子低了很多,所以我个人认为,这次开源的分量比再发一个新模型还要重。
这个判断肯定有人不服,反方的理由也站得住。CUDA积累了二十年,开发者数以百万计,几个库撼动不了这么大的惯性。
21世纪经济报道转载的分析也直说,华为的产能是眼下最主要的瓶颈,芯片供不上,工具再好,也只能先在少数人手里用起来。
这两点我都认,短期内,全球开发者不会因为这批库就搬家,英伟达的基本盘也谈不上动摇,可我觉着,反方把这件事看成了"推倒墙",DeepSeek真正在做的是"开一扇门"。
门开了,国内团队就多了一条能走的路,路上车多车少,要看接下来的产能和用户能不能跟上。