华为昇腾虚假宣传?为什么腾讯放着昇腾芯片不用,却花70亿美元向甲骨文东南亚数据中心租用10万枚AI芯片?
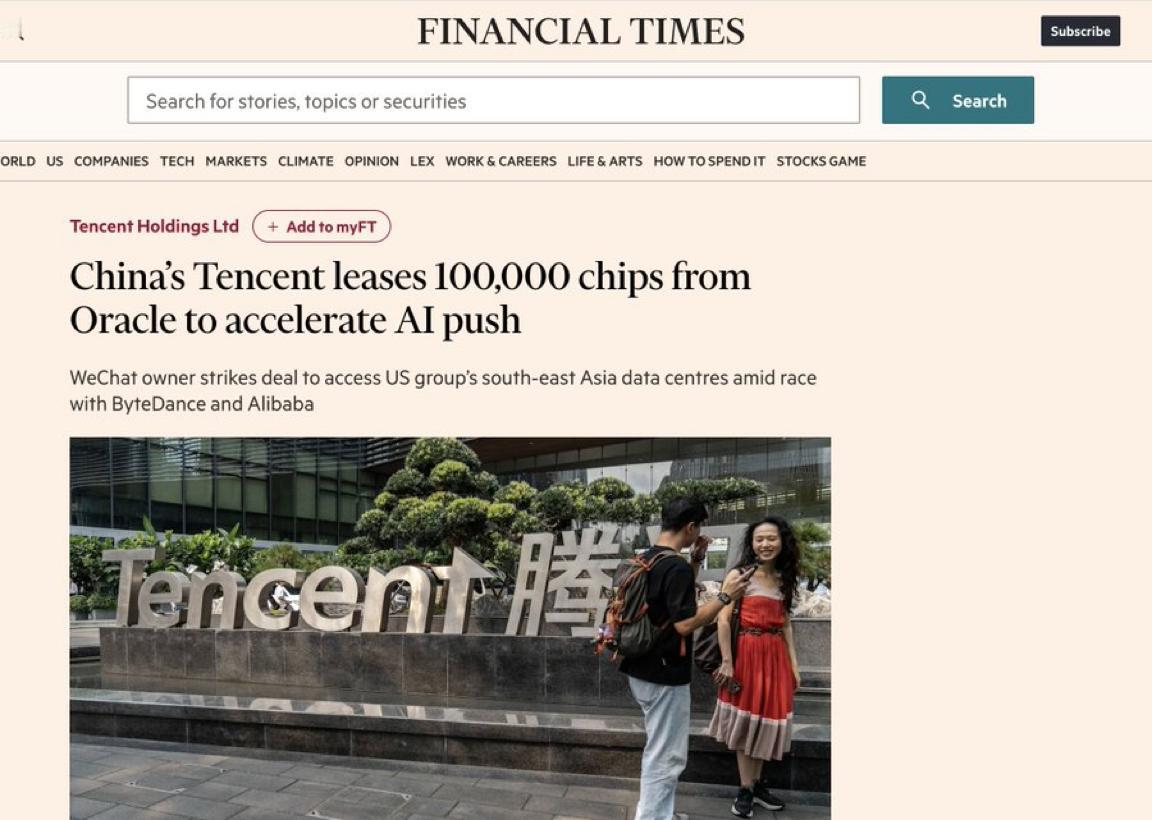
一笔突然曝光的海外算力大单,把腾讯、甲骨文和华为昇腾同时推到了舆论中心。10月1日前后,《金融时报》率先披露,腾讯今年与甲骨文达成一份五年期协议,准备使用甲骨文位于东南亚多个数据中心的先进AI算力,规模约10万枚芯片,合同估值约70亿美元,其中约30%需要提前支付。路透社随后跟进,但特别注明无法独立核实,腾讯和甲骨文当时也没有公开回应。
所以先把第一个问题讲清楚:截至2026年10月8日,“70亿美元、10万枚”属于有权威媒体信源支持的报道,并非腾讯正式公告确认的数据。更重要的是,目前公开报道连具体芯片型号都没有确认,只知道属于中国境内难以获得的先进AI处理器。有媒体将其理解成英伟达高端GPU,但究竟是哪一代、各种型号各占多少,都缺乏腾讯和甲骨文的正式说明。
腾讯现在为什么这么急?看看它今年的投入就明白了。公开报道显示,腾讯2026年第二季度资本开支达到约530亿元,同比增长176%,资金主要投向AI基础设施和算力资源。腾讯一边继续训练混元模型,一边发展智能体、图像生成、视觉语言模型等业务,所需算力已经从“买一些GPU”进入建设超大规模计算资源池的阶段。
这时海外租赁就有一个很现实的优势:腾讯买的其实不是10万块裸芯片,而是已经安装在甲骨文数据中心里的可调用算力。机柜、电力、散热、高速网络、存储和运维体系由云服务商承担。对腾讯而言,只要模型、数据和训练框架符合部署条件,就能迅速增加计算能力,不必自己从零建设海外机房。
第二个因素更加关键——软件生态。全球大量前沿模型研发长期围绕CUDA建立,模型代码、算子库、通信库和训练工具都已经形成庞大的技术体系。腾讯过去积累的大量研发工具同样存在迁移成本。如果为了一个大型训练项目更换底层硬件,绝不是把GPU拔下来、插上另一种芯片那么简单,还涉及算子重写、框架适配、性能调优以及集群稳定性验证。
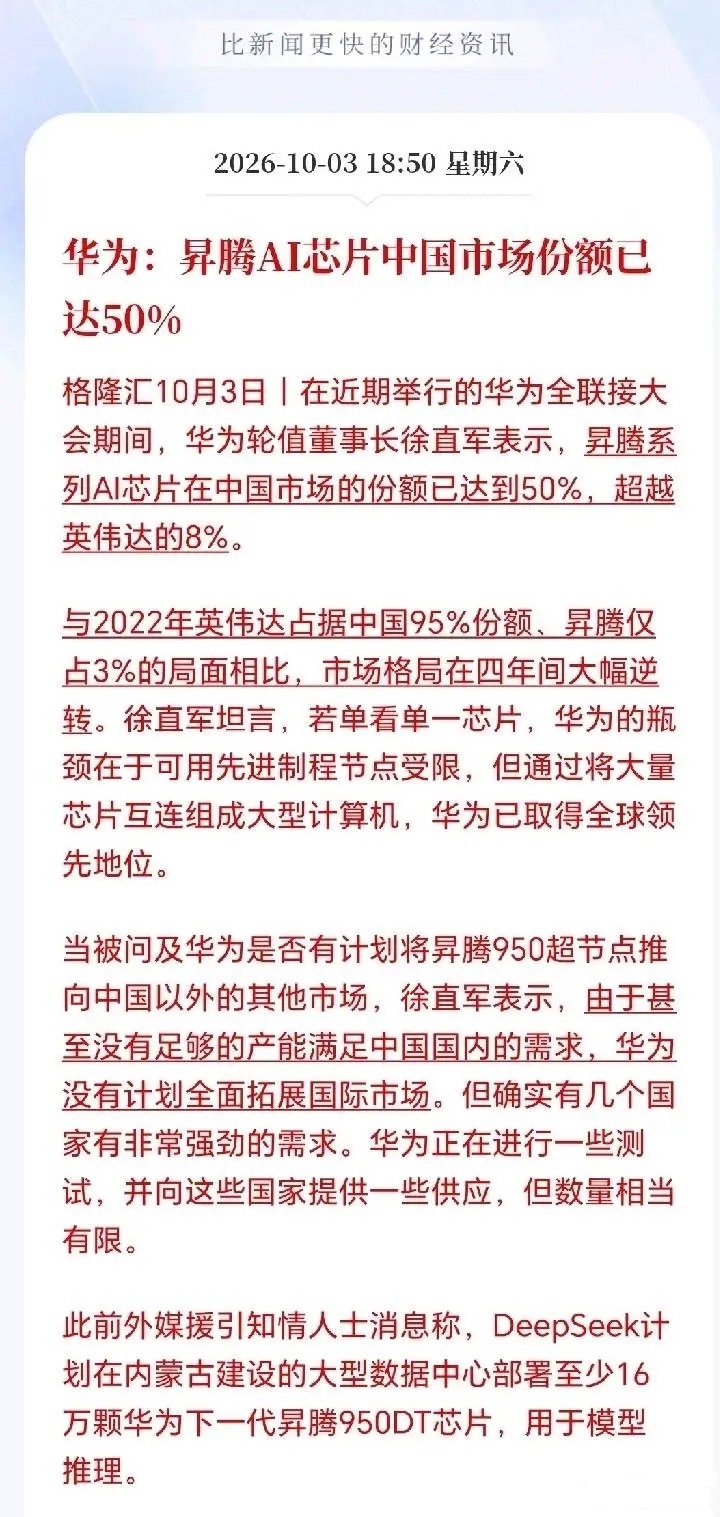
这并不代表昇腾没有实际应用价值。华为今年9月公布的信息显示,昇腾910C超节点已经部署超过1000套,昇腾950超节点进入规模商用阶段。昇腾950超节点公开展示的1024卡系统,面向的正是万亿级模型训练和高并发推理。
软件生态也在继续补课。华为公布的数据称,CANN外部开发者占比已经达到61%,昇腾支持90多个主流第三方社区,并进入PyTorch官方可直接安装支持的算力平台体系。换句话讲,昇腾真正要解决的已经不只是“芯片有没有算力”,而是如何让开发人员更低成本地把现有模型迁移过来。
那么腾讯为什么还要花巨资租海外算力?答案恰恰在“还要”两个字。腾讯面对的是不同任务。国内业务、推理服务以及能够完成国产化适配的模型,可以逐渐扩大国产芯片比例;部分追求极高训练效率、已经围绕海外GPU软件体系开发的前沿模型,则可能继续使用境外算力。这两条路线完全可以同时存在。
而且10万枚这个数字本身也值得注意。如此巨大的集群不是普通推理项目,而更像是在提前锁定未来数年的AI基础设施资源。《金融时报》的报道称协议期限达到五年,腾讯还要支付较高比例的预付款。这意味着腾讯考虑的不只是今天训练一个模型需要多少卡,而是未来模型、智能体和微信等庞大应用体系全面AI化以后需要多少Token产能。
这里还有一个经常被忽视的商业账。按照70亿美元、10万枚芯片、五年粗略平均计算,每枚芯片对应的合同价值约7万美元,但里面还包含数据中心、电力、网络、服务器以及运营服务,并不能拿这个数字直接与购买一块GPU的价格相比。租赁大型云集群与直接采购硬件,本来就是两种成本模型。
因此,把这笔交易解释成“腾讯用脚投票证明昇腾不行”,证据远远不够。真正值得讨论的是,中国大型互联网企业的算力结构正在发生变化:能获得海外先进算力时继续利用成熟生态,同时把国内业务逐渐建立在国产AI基础设施上,通过两套甚至多套硬件体系降低供应风险。这比简单争论哪块芯片跑分高,更符合大型科技企业的现实选择。
腾讯这70亿美元如果后续得到双方正式确认,真正说明的首先是全球顶级AI公司对先进算力的需求已经到了惊人的程度,而不是自动证明某一种国产芯片“造假”。腾讯需要海外10万枚芯片,与中国继续发展昇腾等国产算力并不存在逻辑冲突。一个解决眼前的大规模训练需求,一个解决长期可持续的算力供给,两者面对的时间尺度并不相同。
所以这件事最值得关注的结论,不是“腾讯为什么不用昇腾”这么简单。到了2026年,AI竞争已经从抢几千张卡升级为抢数据中心、抢电力、抢高速互联、抢软件生态。腾讯愿意为五年海外算力支付数十亿美元,恰恰说明下一阶段科技竞争的核心资源已经变了。昇腾真正需要证明自己的地方,也不是网络争论,而是在越来越多真实的大模型训练和推理任务中,把可用算力、稳定性、生态和成本一项项做出来。